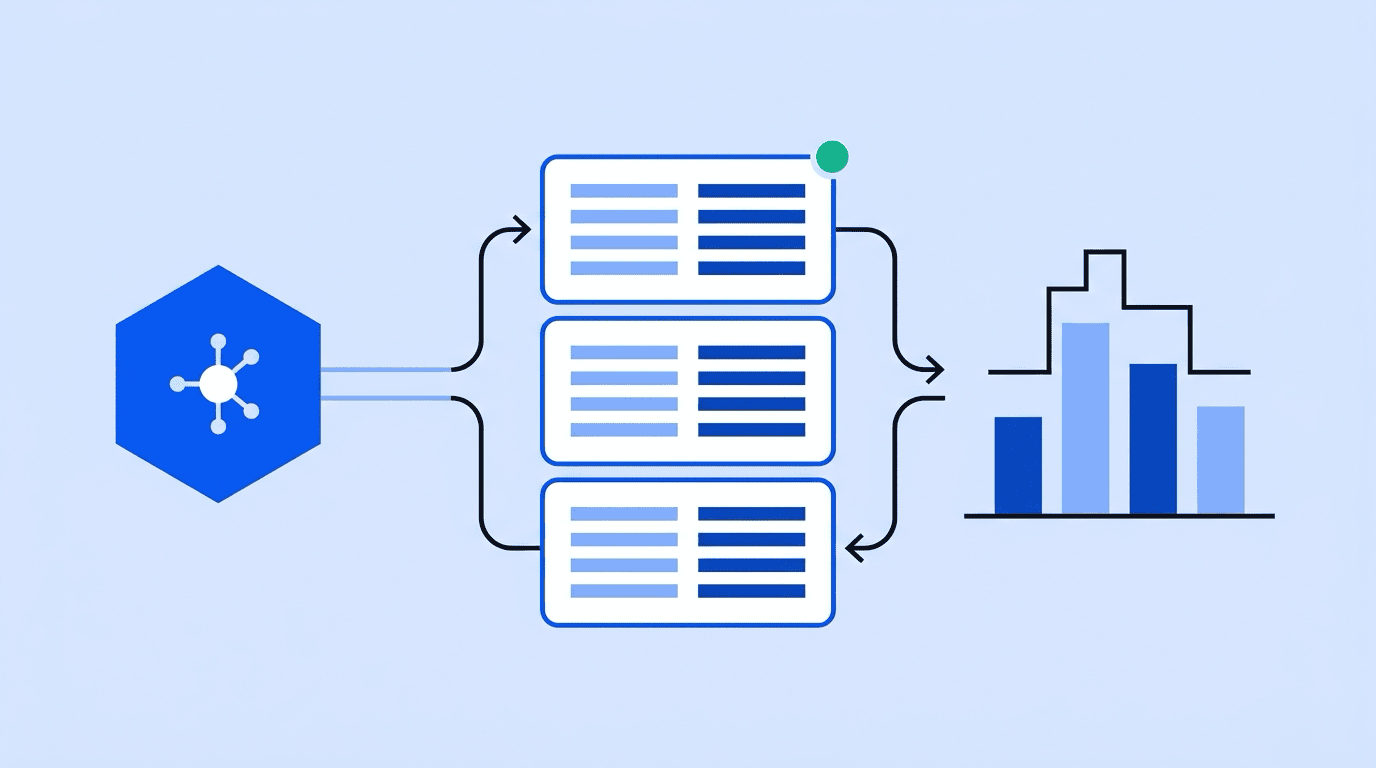
Para integrar validação de CPF em R, use o pacote httr2 para fazer chamadas GET à API https://api.cpfhub.io/cpf/{CPF} com o header x-api-key, e processe as respostas com purrr e dplyr dentro do seu pipeline de análise. A API retorna nome, gênero e data de nascimento em ~150 ms por consulta, o que permite enriquecer dataframes de cadastros diretamente no R sem exportar dados para outros sistemas. Com cache local via SQLite e controle de taxa entre consultas, é possível validar grandes lotes de forma reprodutível e conforme a LGPD.
Configuração do ambiente
Instale os pacotes necessários:
install.packages(c("httr2", "jsonlite", "dplyr", "purrr", "ggplot2", "tidyr"))
Configure a chave de API como variavel de ambiente. Adicione ao seu .Renviron:
CPFHUB_API_KEY=sua_chave_aqui
Recarregue o ambiente:
# Recarregar variaveis de ambiente
readRenviron("~/.Renviron")

# Verificar
Sys.getenv("CPFHUB_API_KEY")
Função de consulta individual
A função principal que consulta a API usando httr2:
# cpfhub.R
library(httr2)
library(jsonlite)

API_URL <- "https://api.cpfhub.io/cpf"
API_KEY <- Sys.getenv("CPFHUB_API_KEY")
TIMEOUT_SECONDS <- 10

#' Limpa formatacao do CPF, mantendo apenas digitos
#' @param cpf String com CPF formatado ou nao
#' @return String com 11 digitos
limpar_cpf <- function(cpf) {
    gsub("[^0-9]", "", as.character(cpf))
}

#' Consulta um CPF na API CPFHub.io
#' @param cpf Numero do CPF (com ou sem formatacao)
#' @return Lista com resultado da consulta
consultar_cpf <- function(cpf) {
    cpf_limpo <- limpar_cpf(cpf)

    if (nchar(cpf_limpo) != 11) {
    return(list(sucesso = FALSE, erro = "CPF deve conter 11 digitos"))
    }

    tryCatch({
    resposta <- request(paste0(API_URL, "/", cpf_limpo)) |>
    req_headers(
    `x-api-key` = API_KEY,
    Accept = "application/json"
    ) |>
    req_timeout(TIMEOUT_SECONDS) |>
    req_error(is_error = function(resp) FALSE) |>
    req_perform()

    status <- resp_status(resposta)

    if (status != 200) {
    return(list(sucesso = FALSE, erro = paste("Erro HTTP:", status)))
    }

    dados <- resp_body_json(resposta)

    if (!isTRUE(dados$success)) {
    return(list(sucesso = FALSE, erro = "CPF nao encontrado"))
    }

    list(
    sucesso = TRUE,
    dados = list(
    cpf = dados$data$cpf,
    nome = dados$data$name,
    nome_upper = dados$data$nameUpper,
    genero = dados$data$gender,
    data_nascimento = dados$data$birthDate,
    dia = dados$data$day,
    mes = dados$data$month,
    ano = dados$data$year
    )
    )
    }, error = function(e) {
    if (grepl("Timeout|timed out", e$message, ignore.case = TRUE)) {
    list(sucesso = FALSE, erro = "Timeout na consulta")
    } else {
    list(sucesso = FALSE, erro = paste("Erro:", e$message))
    }
    })
}
Exemplo de uso:
source("cpfhub.R")

resultado <- consultar_cpf("123.456.789-00")

if (resultado$sucesso) {
    cat("Nome:", resultado$dados$nome, "\n")
    cat("Genero:", resultado$dados$genero, "\n")
    cat("Nascimento:", resultado$dados$data_nascimento, "\n")
} else {
    cat("Erro:", resultado$erro, "\n")
}
Validação em lote com purrr
Para validar uma lista de CPFs, use purrr::map com controle de taxa:
library(dplyr)
library(purrr)

#' Valida uma lista de CPFs com controle de taxa
#' @param cpfs Vetor de CPFs
#' @param delay_segundos Delay entre consultas (padrao: 0.5)
#' @return Dataframe com resultados
validar_lote <- function(cpfs, delay_segundos = 0.5) {
    resultados <- map(cpfs, function(cpf) {
    resultado <- consultar_cpf(cpf)
    Sys.sleep(delay_segundos) # Respeitar rate limits

    if (resultado$sucesso) {
    tibble(
    cpf_consultado = cpf,
    cpf_limpo = resultado$dados$cpf,
    nome = resultado$dados$nome,
    genero = resultado$dados$genero,
    data_nascimento = resultado$dados$data_nascimento,
    ano_nascimento = resultado$dados$ano,
    status = "validado"
    )
    } else {
    tibble(
    cpf_consultado = cpf,
    cpf_limpo = limpar_cpf(cpf),
    nome = NA_character_,
    genero = NA_character_,
    data_nascimento = NA_character_,
    ano_nascimento = NA_integer_,
    status = resultado$erro
    )
    }
    })

    bind_rows(resultados)
}

# Exemplo de uso
cpfs <- c("12345678901", "98765432100", "11122233344")
df_validados <- validar_lote(cpfs)
print(df_validados)
Enriquecimento de dataframes existentes
Integre a validação em um pipeline de dados existente:
library(dplyr)

# Dataframe de exemplo (simulando dados de um CSV)
cadastros <- tibble(
    id = 1:5,
    cpf = c("12345678901", "98765432100", "11122233344",
    "55566677788", "99988877766"),
    nome_informado = c("Joao Silva", "Maria Santos", "Pedro Oliveira",
    "Ana Costa", "Carlos Lima"),
    data_cadastro = Sys.Date() - sample(1:365, 5)
)

# Enriquecer com dados da API
cadastros_enriquecidos <- cadastros |>
    mutate(
    resultado_api = map(cpf, function(c) {
    res <- consultar_cpf(c)
    Sys.sleep(0.5)
    res
    }),
    cpf_valido = map_lgl(resultado_api, ~ .x$sucesso),
    nome_api = map_chr(resultado_api, ~ {
    if (.x$sucesso) .x$dados$nome else NA_character_
    }),
    genero = map_chr(resultado_api, ~ {
    if (.x$sucesso) .x$dados$genero else NA_character_
    }),
    ano_nascimento = map_int(resultado_api, ~ {
    if (.x$sucesso) .x$dados$ano else NA_integer_
    })
    ) |>
    select(-resultado_api)

# Verificar nomes divergentes
cadastros_enriquecidos <- cadastros_enriquecidos |>
    mutate(
    nome_confere = case_when(
    !cpf_valido ~ NA,
    toupper(word(nome_informado, 1)) ==
    toupper(word(nome_api, 1)) ~ TRUE,
    TRUE ~ FALSE
    )
    )

print(cadastros_enriquecidos)
Análise estatistica dos dados validados
Com os dados enriquecidos, execute análises estatisticas:
library(ggplot2)
library(tidyr)

# Supondo que df_validados tem dados reais
# Analise demografica

# Distribuicao por genero
distribuicao_genero <- df_validados |>
    filter(status == "validado") |>
    count(genero) |>
    mutate(
    percentual = n / sum(n) * 100,
    genero_label = case_when(
    genero == "M" ~ "Masculino",
    genero == "F" ~ "Feminino",
    TRUE ~ "Outro"
    )
    )

grafico_genero <- ggplot(distribuicao_genero,
    aes(x = genero_label, y = n, fill = genero_label)) +
    geom_col(width = 0.6) +
    geom_text(aes(label = paste0(round(percentual, 1), "%")),
    vjust = -0.5) +
    labs(
    title = "Distribuicao por Genero dos CPFs Validados",
    x = "Genero",
    y = "Quantidade"
    ) +
    theme_minimal() +
    theme(legend.position = "none")

print(grafico_genero)

# Distribuicao por faixa etaria
df_validados_com_idade <- df_validados |>
    filter(status == "validado") |>
    mutate(
    idade = as.integer(format(Sys.Date(), "%Y")) - ano_nascimento,
    faixa_etaria = cut(
    idade,
    breaks = c(0, 18, 25, 35, 45, 55, 65, 100),
    labels = c("0-17", "18-24", "25-34", "35-44",
    "45-54", "55-64", "65+"),
    right = FALSE
    )
    )

grafico_idade <- ggplot(df_validados_com_idade,
    aes(x = faixa_etaria)) +
    geom_bar(fill = "#4361ee") +
    labs(
    title = "Distribuicao por Faixa Etaria",
    x = "Faixa Etaria",
    y = "Quantidade"
    ) +
    theme_minimal()

print(grafico_idade)
Relatorio de qualidade de dados
Gere um relatorio de qualidade da base de CPFs:
#' Gera relatorio de qualidade da base de CPFs
#' @param df Dataframe com coluna 'status'
#' @return Lista com metricas de qualidade
relatorio_qualidade <- function(df) {
    total <- nrow(df)
    validos <- sum(df$status == "validado", na.rm = TRUE)
    invalidos <- sum(df$status != "validado", na.rm = TRUE)

    nomes_divergentes <- if ("nome_confere" %in% names(df)) {
    sum(!df$nome_confere, na.rm = TRUE)
    } else {
    NA
    }

    list(
    total_registros = total,
    cpfs_validos = validos,
    cpfs_invalidos = invalidos,
    taxa_validacao = round(validos / total * 100, 2),
    nomes_divergentes = nomes_divergentes,
    resumo_erros = df |>
    filter(status != "validado") |>
    count(status, sort = TRUE)
    )
}

relatorio <- relatorio_qualidade(cadastros_enriquecidos)

cat("=== Relatorio de Qualidade ===\n")
cat("Total de registros:", relatorio$total_registros, "\n")
cat("CPFs validos:", relatorio$cpfs_validos, "\n")
cat("CPFs invalidos:", relatorio$cpfs_invalidos, "\n")
cat("Taxa de validacao:", relatorio$taxa_validacao, "%\n")
cat("Nomes divergentes:", relatorio$nomes_divergentes, "\n")
Cache local com SQLite
Para evitar consultas repetidas em sessões diferentes, use SQLite como cache:
library(DBI)
library(RSQLite)

# Inicializar banco de cache
inicializar_cache <- function(db_path = "cpf_cache.sqlite") {
    con <- dbConnect(SQLite(), db_path)
    dbExecute(con, "
    CREATE TABLE IF NOT EXISTS cpf_cache (
    cpf TEXT PRIMARY KEY,
    dados TEXT NOT NULL,
    consultado_em TEXT NOT NULL,
    expira_em TEXT NOT NULL
    )
    ")
    con
}

# Buscar no cache
buscar_cache <- function(con, cpf) {
    cpf_limpo <- limpar_cpf(cpf)
    resultado <- dbGetQuery(con, "
    SELECT dados FROM cpf_cache
    WHERE cpf = ? AND expira_em > datetime('now')
    ", params = list(cpf_limpo))

    if (nrow(resultado) > 0) {
    fromJSON(resultado$dados[1])
    } else {
    NULL
    }
}

# Salvar no cache
salvar_cache <- function(con, cpf, dados, ttl_horas = 24) {
    cpf_limpo <- limpar_cpf(cpf)
    dbExecute(con, "
    INSERT OR REPLACE INTO cpf_cache (cpf, dados, consultado_em, expira_em)
    VALUES (?, ?, datetime('now'), datetime('now', ?))
    ", params = list(cpf_limpo, toJSON(dados), paste0("+", ttl_horas, " hours")))
}

# Consulta com cache
consultar_cpf_com_cache <- function(cpf, con) {
    cached <- buscar_cache(con, cpf)
    if (!is.null(cached)) {
    return(list(sucesso = TRUE, dados = cached, fonte = "cache"))
    }

    resultado <- consultar_cpf(cpf)

    if (resultado$sucesso) {
    salvar_cache(con, cpf, resultado$dados)
    resultado$fonte <- "api"
    }

    resultado
}
Boas práticas para uso em R
- Variavel de ambiente -- Nunca coloque a chave de API diretamente no script. Use
.Renviron. - Rate limiting -- Adicione
Sys.sleep()entre consultas em lote para respeitar os limites da API. - Cache -- Use SQLite para persistir resultados entre sessões.
- Reproducibilidade -- Documente a versão dos pacotes com
renvpara garantir que o pipeline funcione no futuro. A documentação oficial do R traz referências completas sobre os pacotes utilizados neste guia. - Tratamento de erros -- Sempre use
tryCatchpara lidar com falhas de rede em scripts batch.
Perguntas frequentes
Como consultar a API CPFHub.io diretamente do R?
Use o pacote httr2 para construir a requisição GET para https://api.cpfhub.io/cpf/{CPF} com o header x-api-key. A função req_perform() executa a chamada e resp_body_json() converte a resposta em lista R. Cada consulta retorna nome, gênero e data de nascimento em ~150 ms.
A API CPFHub.io funciona para todos os volumes de consulta em R?
O plano gratuito oferece 50 créditos por mês sem cartão de crédito — suficiente para exploração e projetos acadêmicos. Para análises de produção com maior volume, o plano Pro inclui 1.000 créditos mensais por R$149. Funciona dentro da cota, e o fim dela muda conforme o plano: no Grátis, os 50 créditos esgotados geram HTTP 403 com "Limite de créditos excedido" e as consultas param. Se o plano pago incluir excedente, a cobrança sai depois — confira a página de preços. Estourar o ritmo por minuto gera HTTP 429 com Retry-After.
Como garantir conformidade com a LGPD ao usar uma API de CPF em análises de dados?
Use o CPF apenas para a finalidade declarada ao titular, armazene apenas o necessário (não guarde o CPF cru se um token bastar), implemente controle de acesso aos logs de consulta e documente a base legal para o tratamento. A ANPD orienta que dados de identificação devem ser tratados com o princípio da necessidade.
Como evitar consultas duplicadas ao validar grandes lotes de CPFs em R?
Implemente cache local com SQLite usando os pacotes DBI e RSQLite. Antes de cada chamada à API, verifique se o CPF já está no banco com validade vigente. Isso reduz o consumo de cotas e acelera pipelines que reprocessam a mesma base de dados em sessões diferentes.
Conclusão
R e uma ferramenta poderosa para validação e análise de dados cadastrais. A integração com a API da CPFHub.io
Cadastre-se em cpfhub.io
CPFHub.io
Pronto para integrar a API?
50 créditos gratuitos para testar agora. Sem cartão de crédito. Acesso imediato à documentação.